📖 大模型论文学习笔记 · 阶段二 · 第10篇
2019年,微软的Rajbhandari等人发表了ZeRO(Zero Redundancy Optimizer)。听起来就是又一个优化器对吧?但实际上,这篇论文解决的是大模型训练中最核心的瓶颈——GPU显存不够用。
万亿参数的模型,一张GPU根本装不下。多卡并行?传统数据并行的做法是每张卡都存一份完整的模型副本,这等于把显存浪费了N倍。ZeRO做的事情很简单但很优雅:既然每张卡都在算不同的数据,为什么每张卡都要存一份完整的状态?
先搞清楚:显存都花在哪了?
训练一个大模型时,GPU显存大致是这样分配的:
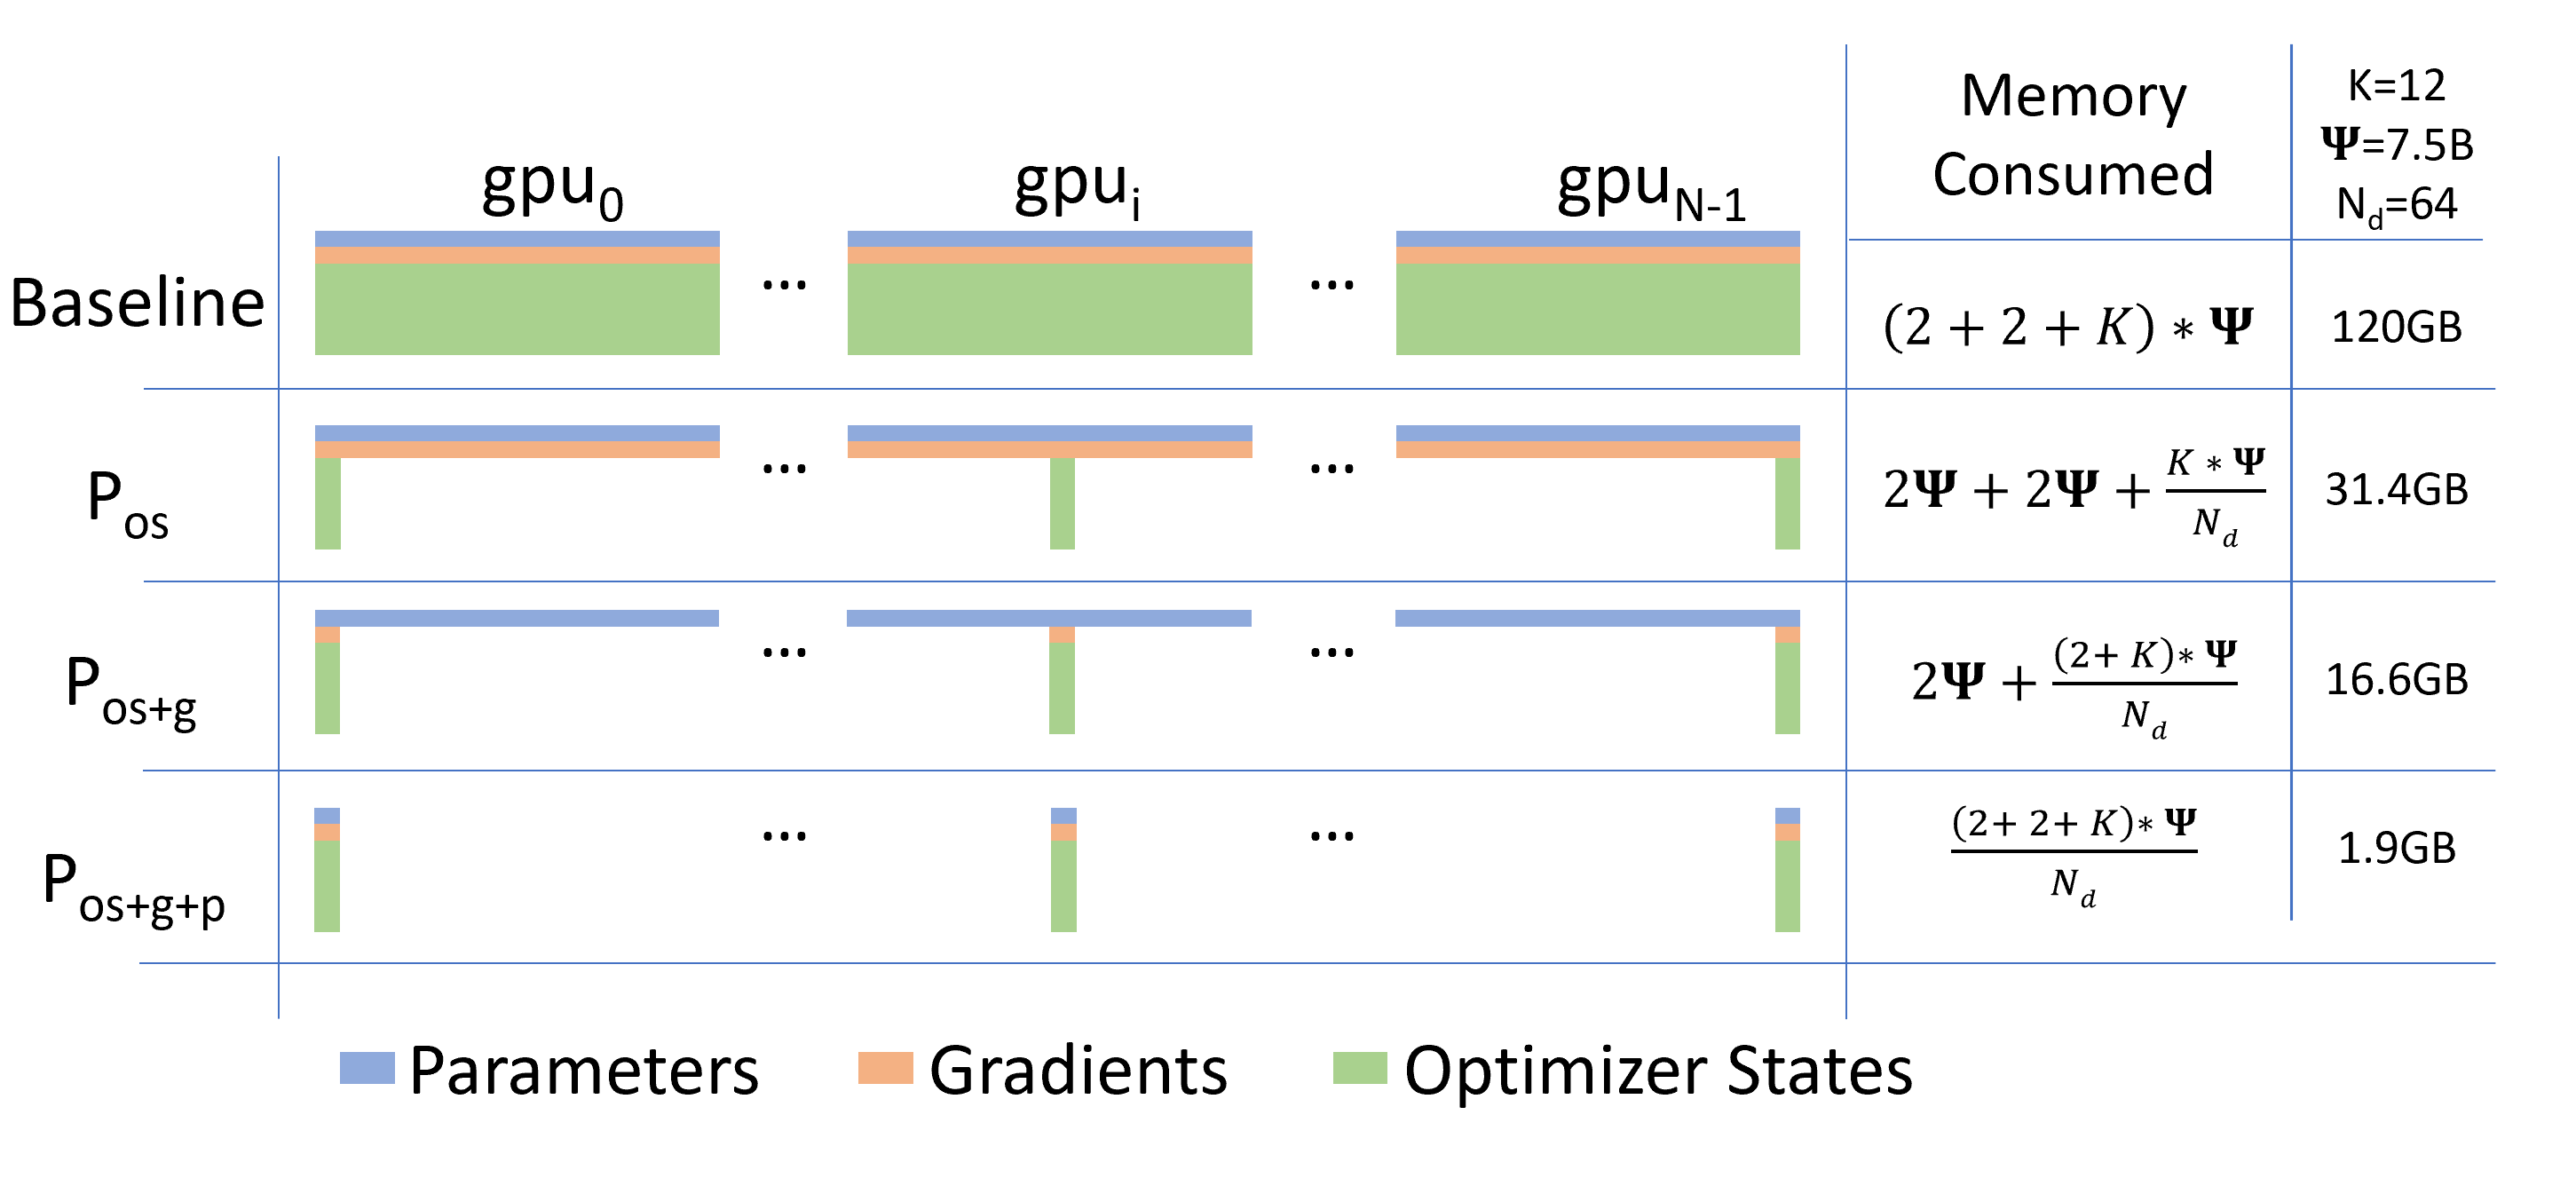
ZeRO三个阶段的每设备显存消耗对比:Stage 1分割优化器状态,Stage 2增加梯度分割,Stage 3进一步分割模型参数(来源:原论文Figure 1)
优化器状态占据了绝大部分(根据原论文 K=12 的数学模型推算,优化器状态约占模型状态总量的 75%),剩下的才是梯度和参数,另外激活值也会占用部分显存(论文对此单独建模,与 batch size 和序列长度有关,并非固定比例)。你没看错,最大的显存杀手不是模型本身,而是优化器状态。
为什么?因为Adam优化器给每个参数都额外存了两个东西:动量 m(记录梯度变化趋势,防止方向来回震荡)和自适应学习率 v(记录梯度变化幅度,步长大的地方调小学习率)。模型有10亿参数,Adam就要为每个参数多存两个数(m 和 v),这额外产生了 20 亿个需要存放的数值。而且m和v通常是 fp32 格式——32 位单精度浮点数(每个数占 4 字节,精度高),而模型参数本身为了省显存用的是 fp16——16 位半精度浮点数(每个数占 2 字节,精度低但够用)。所以优化器状态的每个数本身就比参数大一倍。按原论文 K=12 的数学模型推算,一个参数在混合精度训练时实际占用约 16 字节(fp16 参数 2B + fp16 梯度 2B + fp32 参数副本 4B + Adam 动量 4B + Adam 方差 4B),是 fp16 参数本身的 8 倍,对应每个参数 十多倍 的显存开销。
打个比方:你去超市买菜(模型参数),但Adam优化器要求你同时带一个购物清单(m)和一个价格记录本(v)。菜本身不占多大空间,但那两个本子加起来占了后备箱的一大半。
ZeRO的三阶段分片策略
传统数据并行的做法是:每张GPU都存一份完整副本。4张卡训练同一个模型,优化器状态就存了4份,完全一样的数据复制了4遍。这不就是冗余嘛——ZeRO名字里的 "Zero Redundancy" 就是零冗余的意思。
ZeRO的核心思想是把这些冗余数据切片(partition)分摊到不同GPU上。每张卡只存自己负责的那一小块,需要的时候再通过通信收集齐。
具体来说分三个阶段,每个阶段多切一类数据:
Stage 1:切分优化器状态。优化器状态被均匀分片到所有 GPU 上。这里的“混合精度训练”指的是:前向和反向传播用 fp16 计算(快、省显存),但参数更新时用 fp32 确保精度不会因浮点舍入而丢失。在原论文的混合精度 Adam 模型下,记 Ψ 为模型参数本身的 fp16 大小(1Ψ = 参数量 × 2字节),模型状态总计 16Ψ 字节,其中优化器状态占 12Ψ;将其分片后,单卡显存消耗显著下降。以较大规模并行(如 N_d=64)为例,原论文展示最高可实现约 4 倍 的总显存节省。这个阶段最容易落地,性价比最高。
Stage 2:再切分梯度。在Stage 1基础上,梯度也不全员保存了,每张卡只存跟自己那块优化器状态对应的梯度。效果:8倍 显存节省。
Stage 3:再切分参数。连模型参数本身都分片了。每张GPU只存一部分参数,前向传播和反向传播时通过 all-gather(所有 GPU 各拿出一块参数,广播拼接,最终每张卡都拿到完整结果)临时拼出完整参数。效果:显存节省跟GPU数量成正比,N张卡就是 N倍 节省。
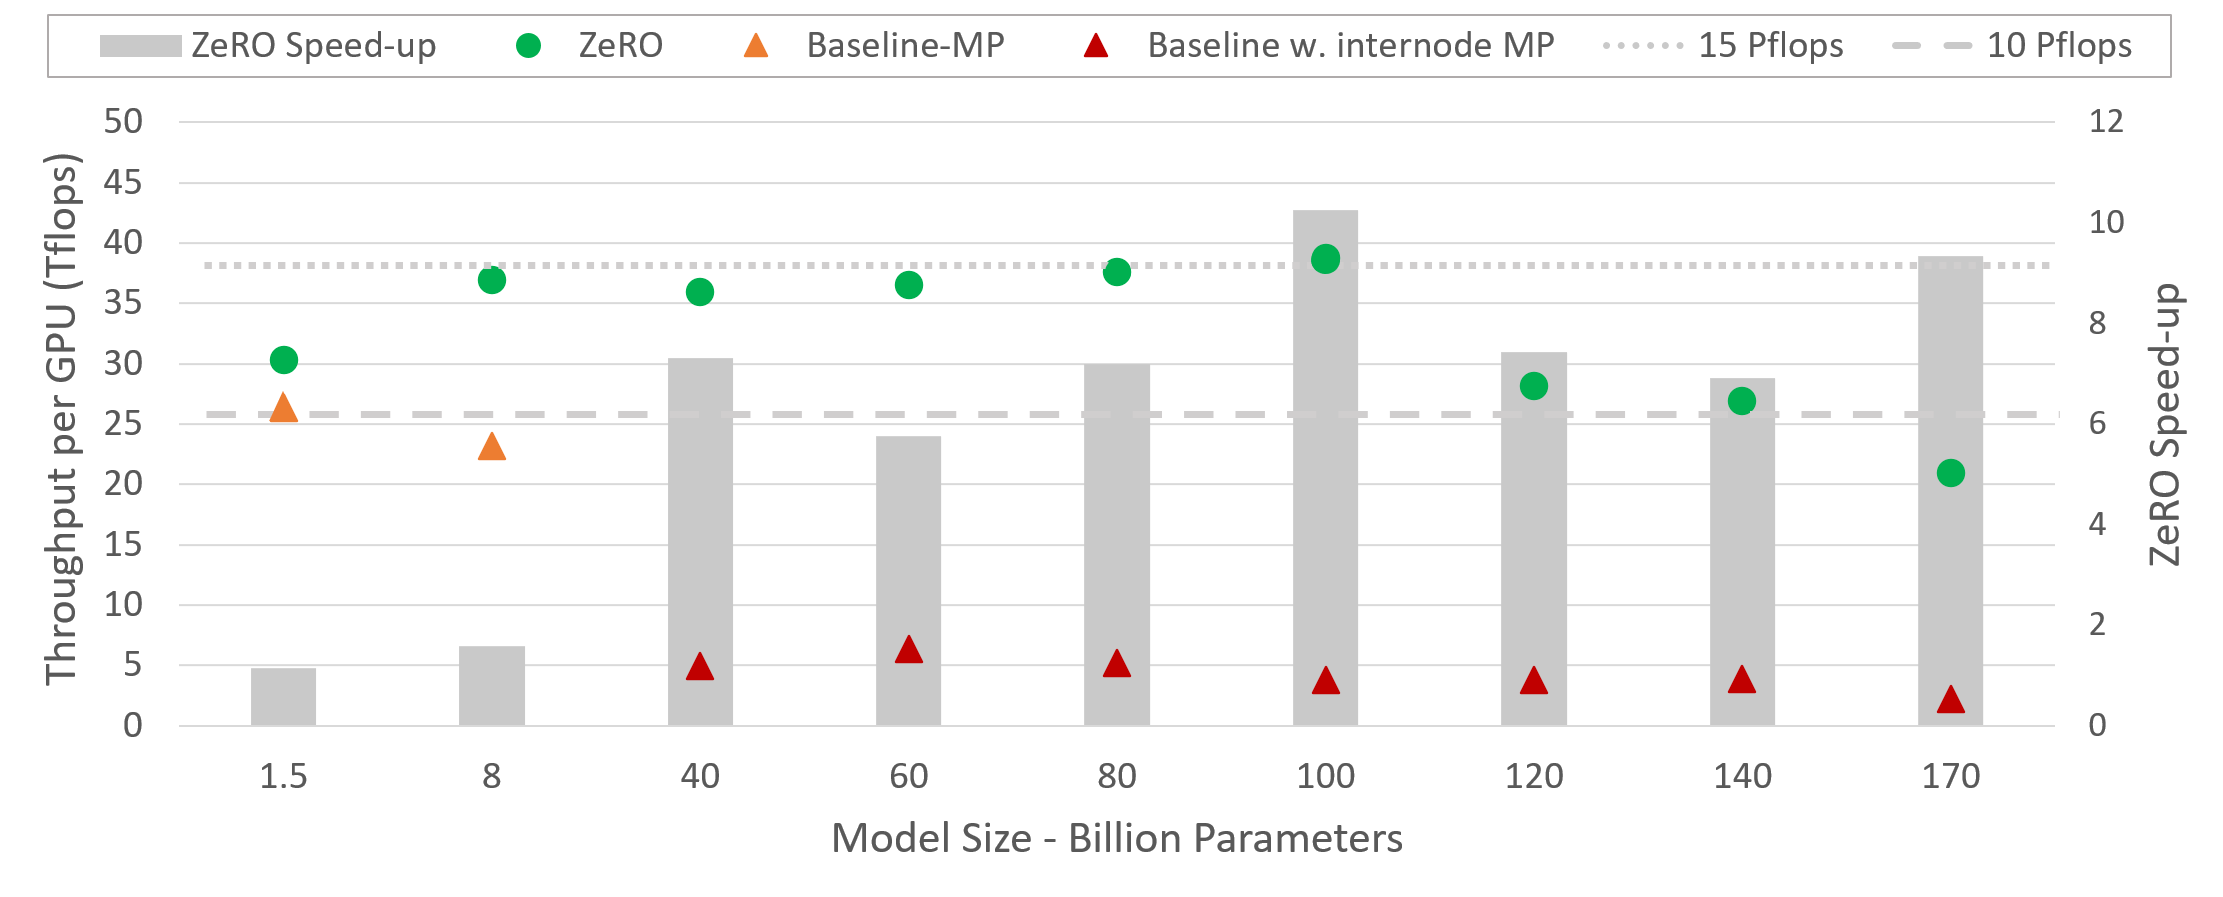
ZeRO在不同模型规模下的训练吞吐量(左)和加速比(右),展示了优异的扩展效率(来源:原论文Figure 2)
回到生活类比:想象一个团队要管理一个巨大的仓库。Stage 1是每个人只管一部分货架的库存账本(优化器状态),Stage 2是连进货记录(梯度)也分摊了,Stage 3是连货物本身(参数)都分散存放,需要的时候从各处调货拼齐。
这跟流水线并行有什么区别?
一个常见的误解是把ZeRO当成流水线并行(Pipeline Parallelism)。不是的。ZeRO本质上是数据并行——每张GPU都在跑同样的模型结构,只是计算不同的数据批次——训练时把一整批数据拆成多个 mini-batch,每张 GPU 领一个小批次独立计算。差别在于存储方式从"每卡存全量"变成了"每卡存分片"。
流水线并行是按层切,第1-10层在GPU A,第11-20层在GPU B,数据像流水线一样依次经过。而 ZeRO——在 Stage 1 和 Stage 2 下所有 GPU 都拥有完整的模型参数,只分片了优化器状态和梯度;在 Stage 3 下,连模型参数本身也分片了,每张 GPU 只存部分参数,计算时通过 all-gather 临时拼齐。
Stage 3 的工作流程是这样的:前向传播时,到了某一层,先通过 all-gather 从其他GPU收集这一层的完整参数,算完立马丢掉,再进入下一层。反向传播也是一样的逻辑。就像出差住酒店——你不会在每个城市都买套房,而是到了当地临时租一间,走了就退房。
通信量会不会爆炸?
这是最妙的地方:不会。
传统数据并行用 AllReduce 做梯度同步,通信量是 2倍参数量(一次 reduce-scatter 加一次 all-gather)。ZeRO Stage 3 用 reduce-scatter 做梯度分片、用 all-gather 做参数收集,总通信量约为标准数据并行 AllReduce 的 1.5 倍,增加有限。
原理其实不复杂:传统 AllReduce 本身就可以拆成 reduce-scatter 和 all-gather 两步。ZeRO 只是把这两步拆开,分别在梯度同步和参数收集时各做一次。总量有少量增加(约 1.5 倍),但增幅是常数级,不随 GPU 数量增长。相当于把一笔一次性付清的账单拆成了分期,多了点手续费,但总金额不会越滚越多。
三个阶段怎么选?
这三个阶段是递进式的,每个阶段都在前一个阶段的基础上增加优化项。你可以只用 Stage 1,也可以启用 Stage 2,或者直接开启包含所有优化的 Stage 3。选择的依据很简单:显存省得越多,通信越频繁,但增幅是常数级(Stage 3 约为 1.5 倍),不会随 GPU 数量增长而恶化为按层数比例。
实践中的建议:
如果你的模型刚好差一点就塞得下,Stage 1 就够了,改动最小,收益明显。如果模型很大需要突破单卡限制,上 Stage 3。Stage 2 是中间态,某些场景下是最优解。
现在主流的训练框架(DeepSpeed、Megatron-LM)都已经把ZeRO集成了。如果你用 DeepSpeed 训练,配置文件里一行 "zero_optimization": {"stage": 3} 就能开启。FSDP(PyTorch原生)本质上也是 ZeRO Stage 3 的思路。
总结一下
ZeRO 的洞察非常直接:数据并行中每张卡存完全一样的东西是浪费。那就切片,每卡存一份,需要时拼。Adam优化器让优化器状态成了显存大户,所以先切它收益最大。三个阶段对应三类数据,你可以按需选择,通信量仅有约 1.5 倍的适度增加。
这个思路现在已经是大规模训练的标配了。理解 ZeRO 是理解现代分布式训练的基石之一。